Website được thiết kế tối ưu cho thành viên chính thức. Hãy Đăng nhập hoặc Đăng ký để truy cập đầy đủ nội dung và chức năng. Nội dung bạn cần không thấy trên website, có thể do bạn chưa đăng nhập. Nếu là thành viên của website, bạn cũng có thể yêu cầu trong nhóm Zalo "CNTT" các nội dung bạn quan tâm.

Phần mềm

Bước 3. Thêm luồng crawl mới

ICT

Chúng ta đã thực hiện xong luồng thứ nhất:

Bước 1. Lấy danh sách

Bước 2. Lấy từng content theo danh sách. Bước 2* là crawl trong Windows.

Với các trang chống bot phức tạp, hay cần đăng nhập thay vì dùng cookies có thể dùng trình duyệt thật trên Windows thay vì dùng Linux.

Bây giờ chúng ta qua luống crawl khác, luồng này mình ưu tiên dùng Windows và dùng proxy. Đây là cách chắc chắn nhất để khi mới tiếp cận, thời gian ít chúng ta có thể vận dụng ngay (Bước 2*).

Một số tình huống khi crawl

ICT

Nếu thực hiện đúng các hướng dẫn trên, thì gặp các vấn đề sẽ rất ít. Ví dụ chặn bot, cần đăng nhập, cần cookies,...

1. Vấn đề đau đầu nhất là khi crawl lần đầu, danh sách lớn. Và có thể bị dừng hoặc có thể có một vài lỗi khiến một số link không tải được. Và script vượt qua, làm link mới. Hoặc có khi không tải đủ số files, loại files. Việc theo vết thủ công là bất khả thi.

Giải pháp: viết script để:

Tạo proxy trên máy chủ có sẵn bằng Tinyproxy

ICT
Nhu cầu: Chỉ cần thêm vài proxy cho mục đích crawl hay vượt qua chống bot; Muốn ổn định, tin cậy, làm chủ hoàn toàn; Nói chung là chu cầu ít, đơn giản thì có thể tham khảo bài này. Nếu cần lượng lớn proxy để spam thì cân nhắc đi thuê, rất rẻ và linh hoạt.

Bước 2*. Tải về từng liên kết trong danh sách sử dụng Windows

ICT

Thường cần dùng đến nếu site có sử dụng CloudFlare để chống bot (mình là bot mà). Do đó cần:

  • Trình duyệt thật
  • Ưu tiên windows
  • Có thể cần vượt qua captcha được (cần trình duyệt mở lên thật để thao tác)
  • Có một lợi thế quan trọng là không cần phải truyền cookies vào do mình dùng trình duyệt thật. Nên chỉ cần dãn cách thời gian crawl thì gần như không có cách nào mà chúng ta bị chặn.

Dưới đây hướng dẫn cả các cài đặt môi trường đến script ví dụ.

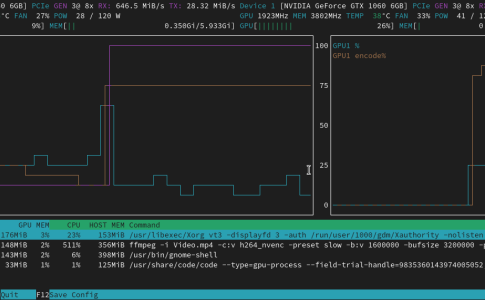
NVTOP – Trình giám sát GPU thời gian thực cho Linux và Apple Silicon

ICT
NVTOP (viết tắt của Neat Videocard TOP) là công cụ dòng lệnh tương tự htop, nhưng dành riêng cho GPU và các bộ tăng tốc phần cứng (accelerators). Nó cho phép người dùng theo dõi chi tiết hiệu năng, mức sử dụng và điện năng của nhiều GPU cùng lúc thông qua giao diện tương tác ngay trong Terminal.

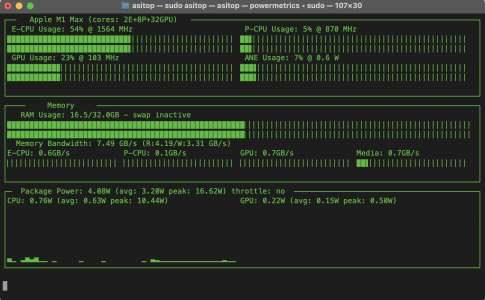
asitop – Công cụ giám sát hiệu năng Apple Silicon trực tiếp trên Terminal

ICT
asitop là một công cụ dòng lệnh (command-line tool) được viết bằng Python, lấy cảm hứng từ nvtop trên hệ thống Linux. Nó cho phép người dùng theo dõi hiệu năng phần cứng của máy Mac dùng chip Apple Silicon (M1, M2, M3...) một cách trực quan ngay trong Terminal.

Ngày giờ hệ thống không đúng

ICT

Giờ của máy chủ AI đang không đúng:

root@ai:/mnt$ date

Fri Oct 17 12:44:49 PM UTC 2025

Lúc này đang là 19:44

Lý do:

Máy đang hiển thị UTC, cần ở UTC+7 (Asia/Ho_Chi_Minh). 12:44 UTC + 7 = 19:44.

Tức là giờ hệ thống chuẩn rồi, chỉ cần đặt đúng timezone để hiển thị theo giờ Việt Nam.

# Xem tình trạng hiện tại
timedatectl

# Đặt timezone về Việt Nam
sudo timedatectl set-timezone Asia/Ho_Chi_Minh

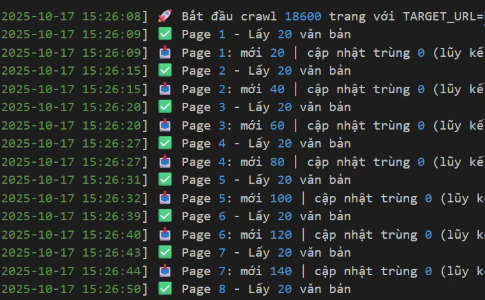
Bước 1. Lấy danh sách bài viết lần đầu

ICT

1. Định hướng

  • Thời gian: chạy duy nhất lần đầu tiên
  • Thường các trang trả phí vẫn cho lấy danh sách mà không cần đăng nhập. Nên bước này không cần cookies.
  • Kiểm tra có khoảng bao nhiêu trang (?page=N) để chạy từ 1 đến N
    • Cách 1. Cho chạy tất cả các trang lần lượt cùng lúc: nếu danh sách sắp xếp theo thứ tự thời gian giảm dần --> cũng không sợ miss bài viết. Nhưng có nguy cơ trùng bài viết --> script cần kiểm tra có bị trùng không mới ghi vào danh sách.
      • Ví dụ này đang dùng cách 1.

Lấy dữ liệu từ website lần đầu

ICT

Tự động lấy dữ liệu từ bất website nào. Ví dụ website đang lấy có trang danh sách toàn bộ bài viết:

https://domainwebiste.com/path/to/danh-sach?page={thứ tự danh sách}

LẦN ĐẦU

Bước 1.1. Lấy danh sách bài viết lần đầu

Việc lập danh sách Link bài viết trước khi lấy rất quan trọng.

Chuyển công việc crawl qua máy khác

ICT

Chúng ta có thể bắt đầu crawl ở 1 máy tính có sẵn, dùng chung với hệ thống khác: laptop, dev, web, AI, ... Nhưng do nhu cầu mở rộng, chuyên nghiệp. Hoặc đơn giản việc crawl thiếu ổn định cũng như gây mất ổn định cho hệ thống khác mà nó đang "ở ké" nên chúng ta cần chuyển nó ra ở riêng.

Một số nguyên tắc:

  • Chưa xóa dữ liệu đích nhé. Chỉ xóa khi bạn đã chắc chắn live tất cả công việc trên Crawl-Server

Bước 1. Cài đặt máy chủ Crawl

  • Tham khảo bài viết: 

Bước 2. Dừng crawl lại

Gồm cả lệnh thủ công hay tự động qua cron